Prostir

Recherchierter Artikel

KI-Agenten vor dem Launch evaluieren

Wer KI-Agenten vor dem Launch evaluieren will, definiert zuerst den Geschäftsjob, baut repräsentative und adversariale Fälle, bewertet Antwort und Werkzeug-Pfad und blockiert die Veröffentlichung, wenn die vereinbarte Schwelle verfehlt wird.

Bevor du liest

Was veröffentlicht wird

Eine Launch-Scorecard für Aufgabenerfolg, Groundedness, Werkzeug-Korrektheit, Sicherheit, Kosten, Recovery und menschliche Prüfung.

Am besten für

Agent-Verantwortlicher und Produktteams, die wiederholbare Version-Evidenz statt Demo-Vertrauen brauchen.

Wo die Arbeit passiert

KI-Agent-Evaluation · Agent-Tests · Version-Gate · Microsoft.Extensions.AI.Evaluation

01

Den Job evaluieren, nicht die Demo

Definieren Sie Ergebnis, erlaubte Werkzeuge, verbotene Aktionen, Evidenz, Kosten, Latenz, Freigaben und Abbruchbedingung vor der Metrik. Eine flüssige Antwort kann einen falschen Schreibvorgang verdecken.

Nutzen Sie normale Aufgaben, Grenzfälle, frühere Fehler, verweigerte Aktionen, feindliche Inhalte, Timeouts, leeres Retrieval und Recovery; binden Sie jeden Fall an eine genaue Revision.

Nutzen Sie deterministische Prüfungen für exakte Regeln und kalibrierte Evaluatoren für Qualität. Menschen entscheiden über mehrdeutige Kriterien, folgenreiche Änderungen und den Launch.
02

Eine wiederholbare Evaluationsschleife

  1. 01
    Begrenztes Dataset erstellen

    Wählen Sie Evidenz ausdrücklich aus, entfernen Sie Secrets und unnötige Daten, definieren Sie Soll-Ergebnisse und trennen Sie Missbrauchs- und Recovery-Fälle.

  2. 02
    Antwort und Verlauf bewerten

    Messen Sie Groundedness, Vollständigkeit, Aufgabe-Treue, Intent, Werkzeug-Wahl und Argumente, Effekte, Wiederholungsversuche, Latenz und Kosten pro erfolgreichem Job.

  3. 03
    Prüfen, verbessern, wiederholen

    Untersuchen Sie Fehler, formulieren Sie eine begrenzte Änderung, lassen Sie einen Menschen entscheiden und vergleichen Sie dieselben Fälle vor der Veröffentlichung.

03

Falsche Sicherheit vermeiden

Einige erfolgreiche Chats sind Beispiele, kein Dataset. Ein Durchschnitt kann eine irreversible Aktion verbergen; kritische Writes brauchen exakte Ablehnungs- und Freigabefälle.

Ein LLM Judge ist keine Ground Truth. Kalibrieren Sie ihn mit menschlichen Labels, behalten Sie exakte Prüfungen und werten Sie Modell-, Billing- oder Infrastrukturfehler nie als Pass.

Evaluation ersetzt weder Sicherheitstest noch Überwachung oder Kundenvalidierung. Halten Sie die Evidenz getrennt.

04

Die Version-Entscheidung definieren

Das nützliche Ergebnis ist keine bunte Zahl, sondern eine Entscheidungsregel, die nach jeder Änderung erneut gilt.

  1. 01
    Schwellen festlegen

    Definieren Sie Mindestgenauigkeit, Nulltoleranzfälle, Kosten, Latenz, Varianz und die Person, die Restrisiko akzeptieren darf.

  2. 02
    Eine exakte Revision testen

    Erfassen Sie Agent, Anweisung, Model, Werkzeuge, Knowledge, Profil, Fälle und Wiederholungen für vergleichbare Ergebnisse.

  3. 03
    Fehler zu Regressionen machen

    Nehmen Sie jeden relevanten Pilot- oder Produktionsfehler auf und verlangen Sie vor der nächsten Veröffentlichung einen Pass.

05

Evaluations in Prostir

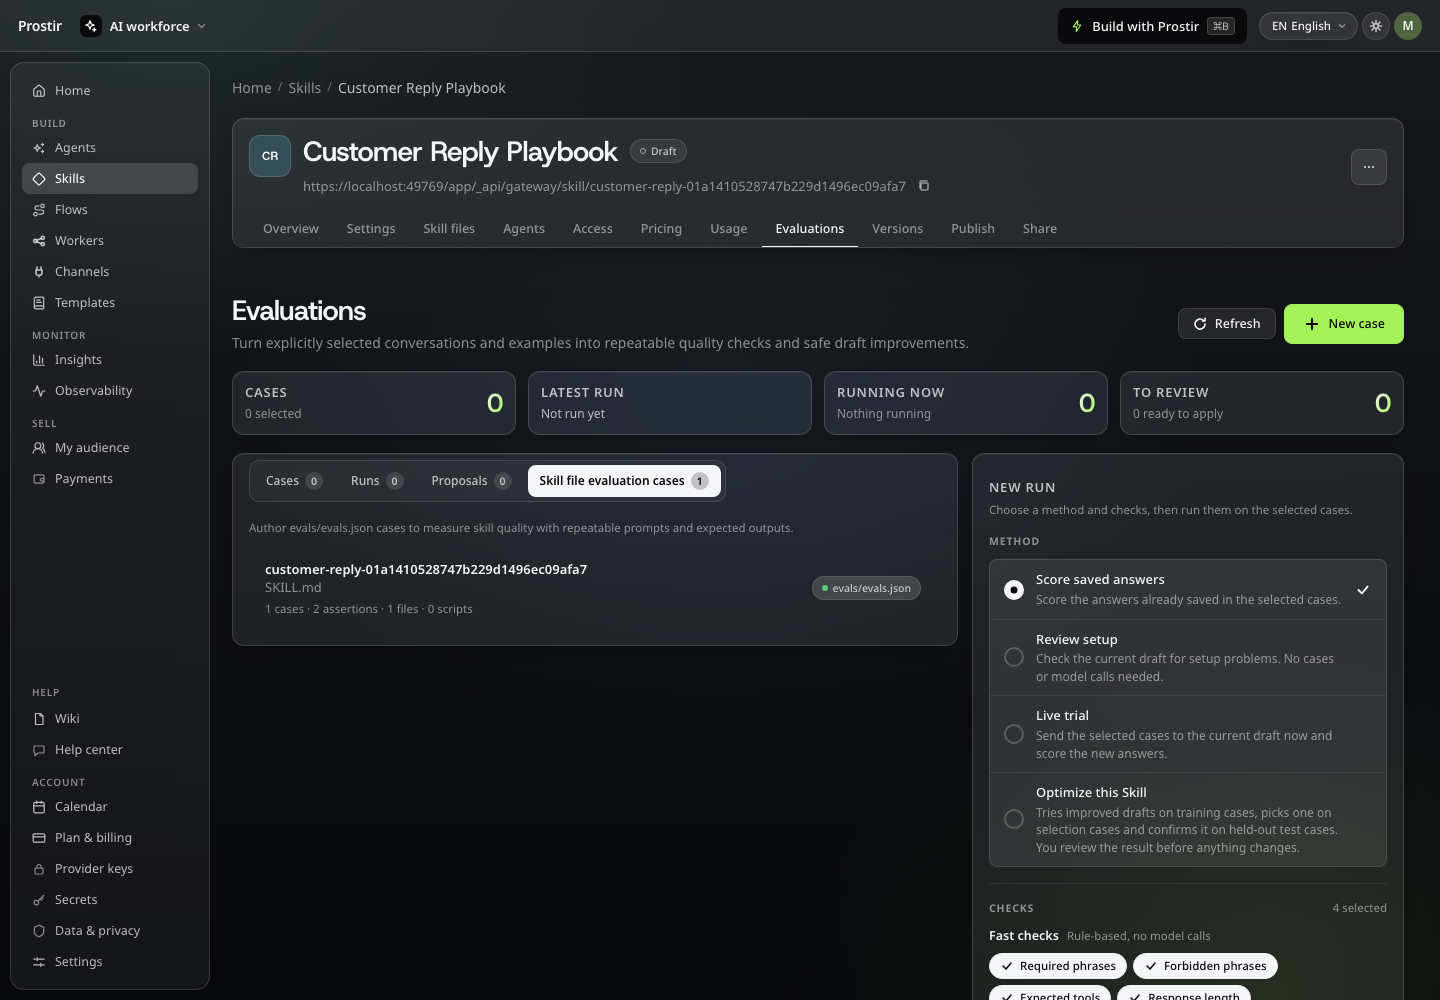
Prostir besitzt ein implementiertes gemeinsames Evaluations-Modul für Agent, Skill und Company mit typisierten Fällen, Profilen, Runs, Ergebnissen, Fehlersignalen und Vorschlägen am exakten Produkt.

Evidenz wird nur nach ausdrücklicher Auswahl und Zustimmung aufgenommen. Deterministische Prüfungen brauchen keinen Judge; Microsoft.Extensions.AI.Evaluation erfordert Kreditfreigabe und positives Budget.

Ein Run ändert oder veröffentlicht nie das Produkt. Ein Vorschlag wartet auf menschliche Prüfung und darf nur den Entwurf ändern, dessen genaue Revision noch aktuell ist.

06

Was, wenn eine Antwort falsch ist oder eine Aufgabe unfertig bleibt?

KI kann eine Anfrage weiterhin falsch verstehen, schlecht belegte Informationen verwenden oder bei einer Aktion scheitern. Gib Agent gute Quellen und klare Grenzen und teste auch Beispiele mit Fehlern. Prüfe bei Flow den Ablauf und das gespeicherte Ergebnis, statt eine selbstsichere Antwort als Beleg für den Abschluss zu nehmen.

Ein Beispiel mit Prostir

Frage Store nach einem Produkt für ein bestimmtes Liefergebiet. Der Graph kann Informationen über Produkte, Lieferung und Rückgaben miteinander verbinden. Aktueller Preis, Lagerbestand und Kaufabwicklung müssen weiterhin vom Handelssystem bestätigt werden.

Sieh dir die Bewertungsfälle an und lass Builder eine wiederverwendbare Prüfliste für Antworten ergänzen.

Was du zuerst prüfen solltest

Teste ein nicht verfügbares Produkt, widersprüchliche Quellen und eine unterbrochene Aktion. Prüfe das tatsächlich gespeicherte Ergebnis, bevor du die Aufgabe als erledigt betrachtest.

Prüfe ihn, bevor andere darauf vertrauen Beispiele und Bewertungen.
Beispiele und Bewertungen.

Lösungen

KI-Agent erstellen, passend zu deiner Arbeit

Ein Agent mit klarem Auftrag, deinem Geschäftskontext und einem Zugang für die richtigen Personen. Teste echte Anfragen, prüfe Quellen und Aktionen und verbessere ihn in Builder vor der Einladung.

Lösungen

Dein nächster Agent beginnt mit deiner Arbeit.

Wähle eine Kundenfrage oder Routineaufgabe und erstelle einen Agenten mit deinem Wissen. Starte 7 Tage Creator ohne Kreditkarte.

Bildvorschau