Prostir

Onderzocht artikel

AI Agents evalueren vóór lancering

Om een AI Agent vóór lancering te evalueren, definieer je de taak, bouw je representatieve en adversarial cases, beoordeel je antwoord en hulpmiddel-traject en blokkeer je publicatie wanneer de afgesproken drempel niet wordt gehaald.

Voordat je leest

Wat wordt gepubliceerd

Een launch-scorekaart voor tasksucces, groundedness, juiste hulpmiddelen, veiligheid, kosten, herstel en menselijke beoordeling.

Beste voor

Agent verantwoordelijken en productteams die herhaalbaar releasebewijs willen in plaats van vertrouwen in een demo.

Waar het werk gebeurt

Evaluatie AI Agent · Agenttest · Versie-gate · Microsoft.Extensions.AI.Evaluatie

01

Evalueer de taak, niet de demo

Definieer resultaat, toegestane hulpmiddelen, verboden acties, bewijs, kosten, latency, goedkeuringen en stopvoorwaarde vóór de maatstaf. Een vloeiend antwoord kan een verkeerde write verbergen.

Gebruik gewone taken, edge cases, eerdere fouten, weigeringen, vijandige inhoud, timeouts, lege retrieval en herstel; koppel elke case aan een exacte versie.

Gebruik deterministische controles voor exacte regels en gekalibreerde evaluators voor kwaliteit. Mensen beslissen over onduidelijke criteria, wijzigingen met hoge impact en de launch.
02

Een herhaalbare evaluatielus

  1. 01
    Bouw een begrensde gegevensverzameling

    Selecteer bewijs expliciet, verwijder secrets en onnodige gegevens, definieer verwachte uitkomsten en scheid misbruik van herstel.

  2. 02
    Score antwoord en traject

    Meet groundedness, volledigheid, taak adherence, intent, toolkeuze en argumenten, effecten, nieuwe pogingen, latency en kosten per geslaagde taak.

  3. 03
    Beoordeling, verbeter en herhaal

    Onderzoek failures, stel een begrensde wijziging voor, laat een mens beslissen en vergelijk dezelfde cases vóór publicatie.

03

Vermijd schijnzekerheid

Een paar geslaagde chats zijn voorbeelden, geen gegevensverzameling. Een gemiddelde kan één onomkeerbare actie verbergen; kritieke writes vereisen exacte weigerings- en goedkeuring-cases.

Een LLM judge is geen ground truth. Kalibreer met menselijke labels, behoud exacte controles en maak van model-, billing- of infrastructuurfouten nooit een pass.

Evaluatie vervangt geen securitytest, bewaking of klantvalidatie. Houd deze bewijsstromen gescheiden.

04

Definieer het releasebesluit

De nuttige uitkomst is een beslisregel die na elke wijziging opnieuw werkt, geen kleurige score.

  1. 01
    Stel drempels in

    Definieer minimale nauwkeurigheid, zero-tolerance-cases, kosten, latency, variatie en wie restrisico mag accepteren.

  2. 02
    Proef een exacte versie

    Leg Agent, instructie, model, hulpmiddelen, Knowledge, profiel, cases en herhalingen vast voor vergelijkbare resultaten.

  3. 03
    Maak failures regressies

    Voeg elke materiële proefproject- of productiefout toe en vereis een pass vóór de volgende publicatie.

05

Evaluations in Prostir

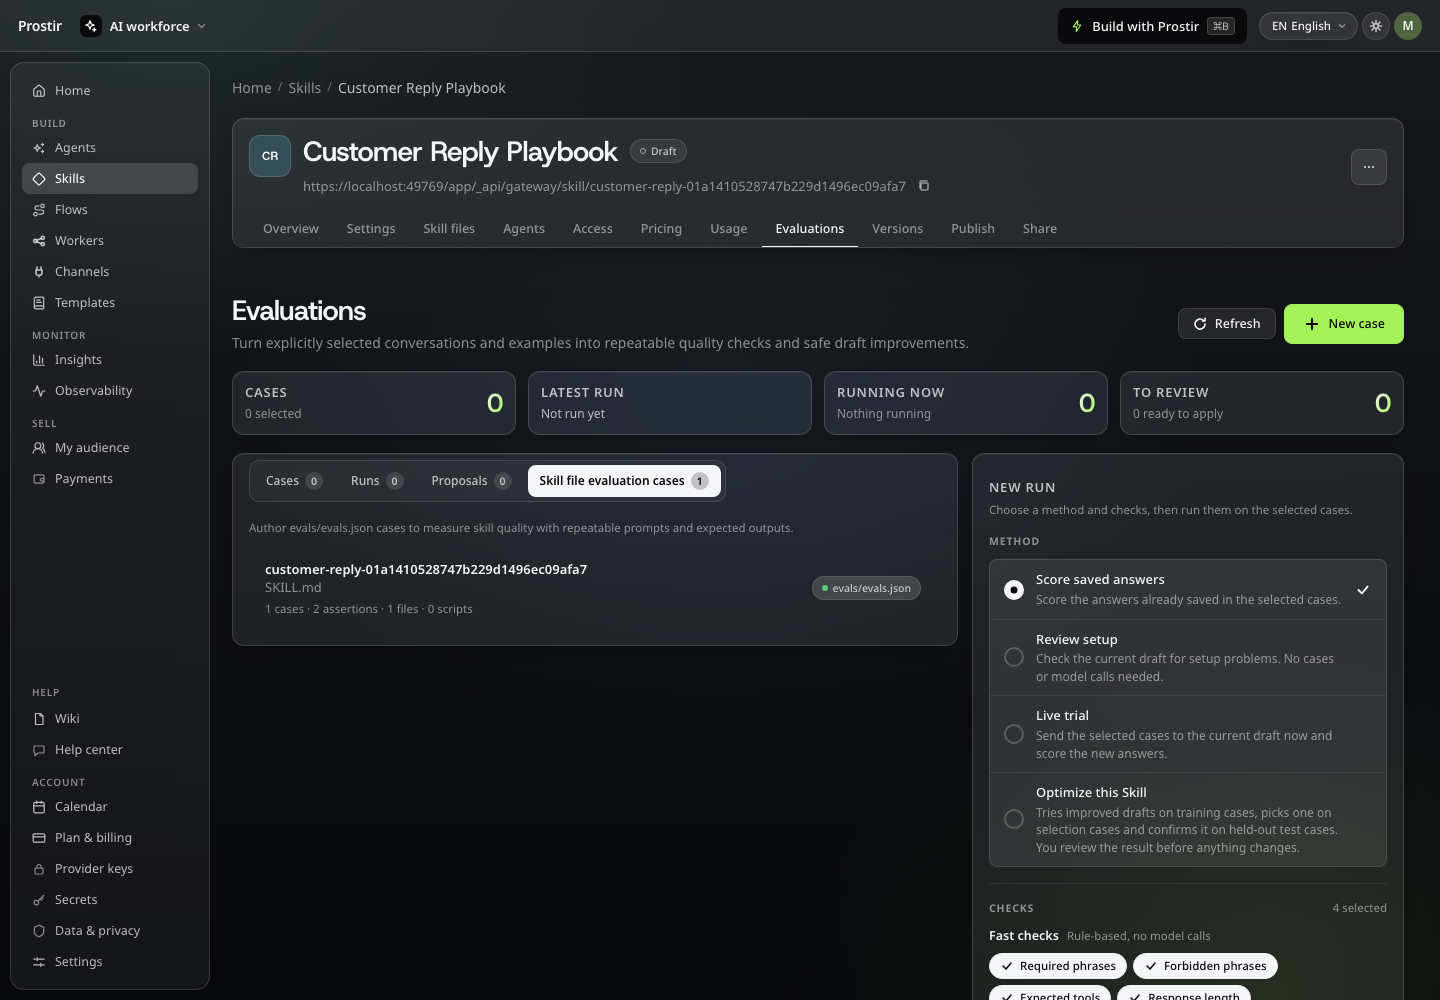
Prostir heeft één geïmplementeerde Evaluations-module voor Agent, Skill en Company met getypeerde cases, profielen, runs, resultaten, failuresignalen en voorstellen onder het exacte product.

Bewijs komt alleen binnen na expliciete selectie en toestemming. Deterministische controles hebben geen judge nodig; Microsoft.Extensions.AI.Evaluatie vereist kredietautorisatie en een positief budget.

Een run wijzigt of publiceert het product nooit. Een voorstel wacht op menselijke beoordeling en mag alleen de concept wijzigen waarvan de exacte versie nog actueel is.

06

Wat als het antwoord niet klopt of het werk half blijft liggen?

AI kan een verzoek verkeerd begrijpen, zwakke informatie gebruiken of tijdens een handeling vastlopen. Geef de agent goede bronnen en duidelijke grenzen en test ook moeilijke gevallen. Bekijk bij een Flow de uitvoering en het opgeslagen resultaat: een stellig antwoord bewijst niet dat de taak klaar is.

Een voorbeeld in Prostir

Vraag een Store naar een product voor een bepaalde bezorgregio. De graaf verbindt producten, bezorging en retouren; de actuele prijs, voorraad en bestelling moeten nog steeds door het verkoopsysteem worden bevestigd.

Bekijk de beoordelingsgevallen en vraag Builder een herbruikbare controlelijst voor antwoorden toe te voegen.

Wat je eerst controleert

Test een niet-leverbaar product, tegenstrijdige bronnen en een onderbroken handeling. Bekijk wat werkelijk is opgeslagen voordat je de taak als afgerond beschouwt.

Controleer voordat iemand erop vertrouwt Voorbeelden en beoordelingen.
Voorbeelden en beoordelingen.

Oplossingen

AI-agentbouwer voor het werk van je bedrijf

Een Agent met een heldere taak, jouw bedrijfscontext en een werkende toegang voor de juiste mensen. Proef echte verzoeken, bekijk bronnen en toegestane acties en verbeter het gedrag in Builder voordat je anderen uitnodigt.

Oplossingen

Je volgende Agent begint bij je werk.

Kies één klantvraag of terugkerende taak en bouw er met eigen kennis een Agent voor. Begin met de Creator-proefperiode van 7 dagen zonder betaalkaart.

Afbeeldingsvoorbeeld