Prostir

Researchbaseret artikel

Sådan evaluerer du AI-agenter før lancering

For at evaluere en AI-agent før lancering skal du definere jobbet, bygge repræsentative og adversarial cases, bedømme svar og værktøj-forløb og blokere publicering, hvis den aftalte tærskel ikke nås.

Før du læser

Hvad bliver offentliggjort

Et lanceringskort for opgavesucces, groundedness, værktøj-korrekthed, sikkerhed, pris, gendannelse og menneskelig gennemgang.

Bedst til

Agent-ejere og produktteams, der vil have gentagelig version-evidens frem for tillid til en demo.

Hvor arbejdet foregår

Evaluering AI-agent · Agenttest · Version gate · Microsoft.Extensions.AI.Evaluering

01

Evaluér jobbet, ikke demoen

Definér resultat, tilladte værktøjer, forbudte handlinger, evidens, pris, latenstid, godkendelser og stopbetingelse før metrikkens valg. Et flydende svar kan skjule et forkert write.

Medtag almindelige opgaver, edge cases, tidligere fejl, afvisninger, fjendtligt indhold, timeouts, tom retrieval og gendannelse; bind hver sag til en præcis version.

Brug deterministiske kontroller til præcise regler og kalibrerede evaluators til kvalitet. Mennesker afgør tvetydige kriterier, ændringer med høj påvirkning og lancering.
02

Et gentageligt evalueringsloop

  1. 01
    Byg et afgrænset datasæt

    Vælg evidens eksplicit, fjern secrets og unødvendige data, definér forventede resultater og adskil misbrug og gendannelse.

  2. 02
    Bedøm svar og forløb

    Mål groundedness, fuldstændighed, opgave adherence, intent, værktøj-valg og argumenter, effekter, nye forsøg, latenstid og pris pr. vellykket job.

  3. 03
    Gennemgå, forbedr og gentag

    Undersøg fejl, foreslå en afgrænset ændring, få en menneskelig beslutning og sammenlign de samme cases før publicering.

03

Undgå falsk sikkerhed

Nogle få vellykkede chats er eksempler, ikke et datasæt. Et gennemsnit kan skjule en irreversibel handling; kritiske writes kræver præcise afvisnings- og godkendelsescases.

En LLM judge er ikke ground truth. Kalibrér mod menneskelige labels, behold præcise kontroller og gør aldrig model-, billing- eller infrastrukturfejl til pass.

Evaluering erstatter ikke sikkerhedstest, monitorering eller kundevalidering. Hold evidenssporene adskilt.

04

Definér releasebeslutningen

Det nyttige output er en beslutningsregel, som kan genbruges efter hver ændring, ikke en farvet score.

  1. 01
    Sæt tærskler

    Definér mindste nøjagtighed, nultolerancecases, pris, latenstid, variation og hvem der må acceptere restrisiko.

  2. 02
    Kør en præcis version

    Registrér Agent, instruktion, model, værktøjer, Knowledge, profil, cases og gentagelser for sammenlignelige resultater.

  3. 03
    Gør fejl til regressioner

    Tilføj enhver væsentlig pilot- eller produktionsfejl og kræv pass før næste publicering.

05

Evaluations i Prostir

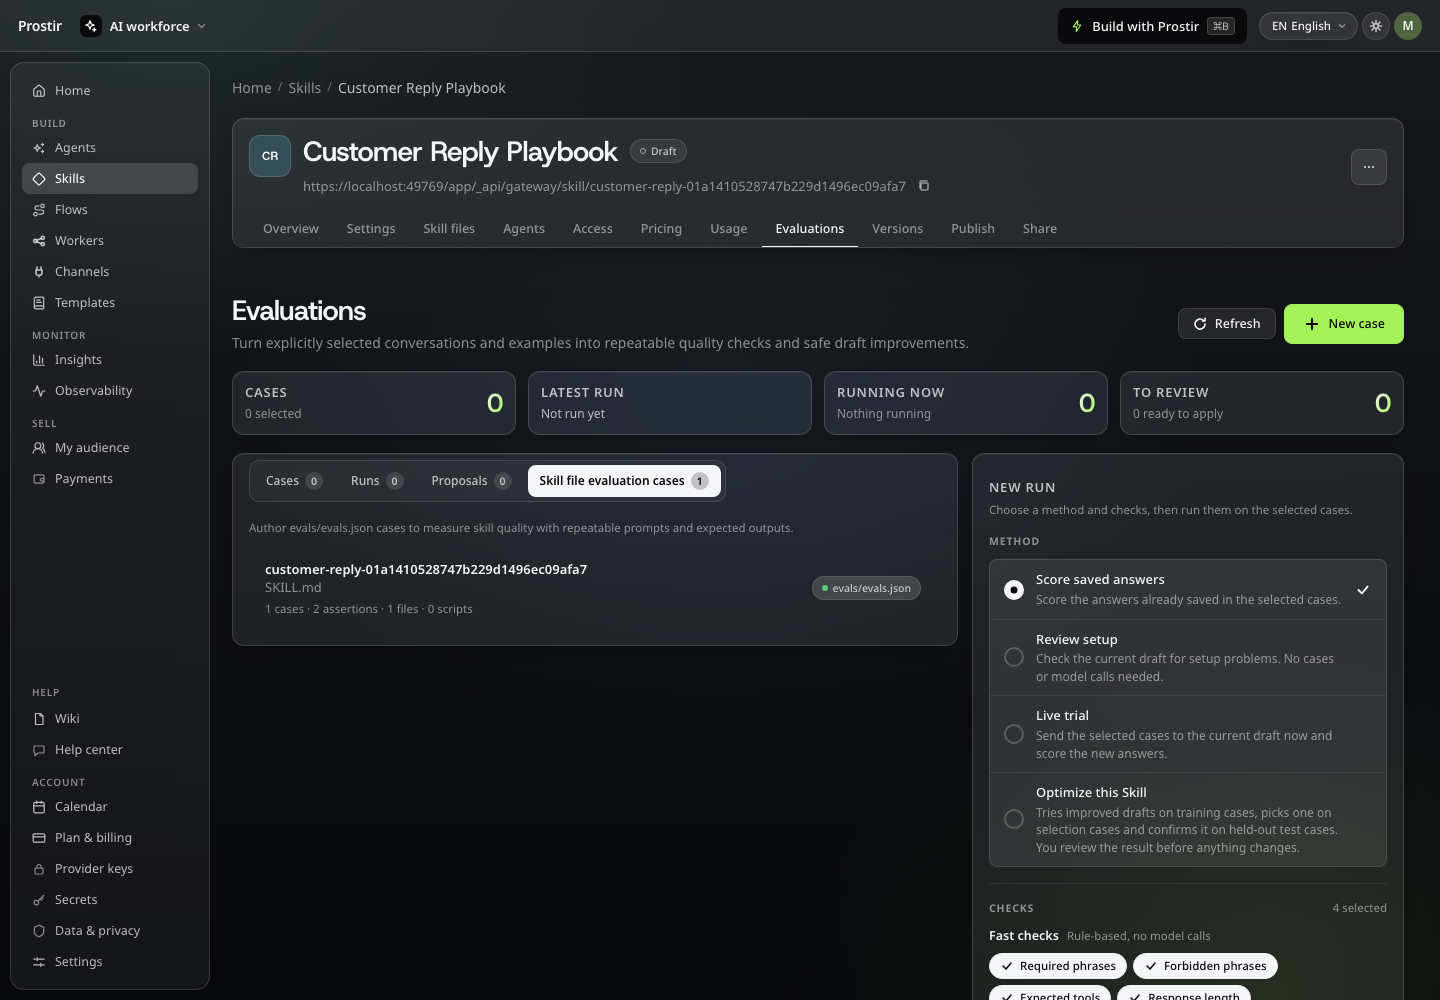
Prostir har ét implementeret Evaluations-modul delt af Agent, Skill og Company med typede cases, profiler, runs, resultater, fejlsignaler og forslag på det præcise produkt.

Evidens optages kun efter eksplicit valg og samtykke. Deterministiske kontroller behøver ingen judge; Microsoft.Extensions.AI.Evaluering kræver kreditgodkendelse og positivt budget.

En run ændrer eller publicerer aldrig produktet. Et forslag venter på menneskelig gennemgang og må kun ændre det kladde, hvis præcise version stadig er gældende.

06

Hvad hvis den svarer forkert eller ikke gør opgaven færdig?

AI kan stadig misforstå en anmodning, bruge mangelfulde oplysninger eller fejle under en handling. Giv din Agent gode kilder og klare grænser, og test også eksempler med fejl. Bruger du Flow, så kontrollér kørslen og det gemte resultat. Et selvsikkert svar beviser ikke, at opgaven er færdig.

Et eksempel med Prostir

Spørg Store om et produkt til et bestemt leveringsområde. Dens vidensgraf kan forbinde oplysninger om produkter, levering og returregler. Aktuel pris, lagerstatus og bestilling skal stadig bekræftes af handelssystemet.

Gennemgå eksemplerne til vurdering, og bed Builder tilføje en tjekliste til svar, som du kan genbruge.

Det skal du tjekke først

Test et produkt, der ikke kan købes, kilder, der modsiger hinanden, og en afbrudt handling. Kontrollér det faktiske gemte resultat, før du regner opgaven for afsluttet.

Kontrollér før andre stoler på den Eksempler og evalueringer.
Eksempler og evalueringer.

Løsninger

Byg en AI-agent til den måde, din virksomhed arbejder på

En agent med en tydelig opgave, virksomhedens viden og en praktisk vej til brugerne. Test rigtige spørgsmål, undersøg kilder og tilladte handlinger, og tilpas i Builder før invitationer.

Løsninger

Din næste agent begynder med dit arbejde.

Vælg ét kundespørgsmål eller en rutine, og byg en agent med din egen viden. Start med 7 dages Creator-prøve uden betalingskort.

Billedvisning