Prostir

Researchbasert artikkel

Slik evaluerer du AI-agenter før lansering

For å evaluere en AI-agent før lansering må du definere jobben, bygge representative og adversarial cases, vurdere svar og verktøy-forløp og blokkere publisering hvis avtalt terskel ikke nås.

Før du leser

Hva blir publisert

Et lanseringskort for oppgavesuksess, groundedness, verktøy-korrekthet, sikkerhet, kostnad, gjenoppretting og menneskelig gjennomgang.

Passer best for

Agent-eiere og produktteam som trenger repeterbar versjon-evidens i stedet for tillit til en demo.

Hvor arbeidet skjer

Evaluering AI-agent · Agenttest · Versjon gate · Microsoft.Extensions.AI.Evaluering

01

Evaluer jobben, ikke demoen

Definer resultat, tillatte verktøy, forbudte handlinger, evidens, kostnad, ventetid, godkjenninger og stoppvilkår før metrikk. Et flytende svar kan skjule en feil write.

Ta med vanlige oppgaver, edge cases, tidligere feil, avslag, fiendtlig innhold, timeouts, tom retrieval og gjenoppretting; knytt hvert tilfelle til en eksakt revisjon.

Bruk deterministiske kontroller for eksakte regler og kalibrerte evaluators for kvalitet. Mennesker avgjør tvetydige kriterier, endringer med høy påvirkning og lansering.
02

En repeterbar evalueringssløyfe

  1. 01
    Bygg et avgrenset datasett

    Velg evidens eksplisitt, fjern secrets og unødvendige data, definer forventede resultater og ferdighet misbruk fra gjenoppretting.

  2. 02
    Vurder svar og forløp

    Mål groundedness, fullstendighet, oppgave adherence, intent, verktøy-valg og argumenter, effekter, nye forsøk, ventetid og kostnad per vellykket jobb.

  3. 03
    Gjennomgå, forbedre og gjenta

    Undersøk feil, foreslå en avgrenset endring, få en menneskelig beslutning og sammenlign de samme tilfellene før publisering.

03

Unngå falsk trygghet

Noen vellykkede chatter er eksempler, ikke et datasett. Et gjennomsnitt kan skjule en irreversibel handling; kritiske writes trenger eksakte avvisnings- og godkjenningstilfeller.

En LLM judge er ikke ground truth. Kalibrer mot menneskelige labels, behold eksakte kontroller og gjør aldri modell-, billing- eller infrastrukturfeil til pass.

Evaluering erstatter ikke sikkerhetstest, overvåking eller kundevalidering. Hold evidenssporene adskilt.

04

Definer releasebeslutningen

Det nyttige resultatet er en beslutningsregel som kan brukes igjen etter hver endring, ikke en fargerik score.

  1. 01
    Sett terskler

    Definer minste nøyaktighet, nulltoleransetilfeller, kostnad, ventetid, variasjon og hvem som kan godta restrisiko.

  2. 02
    Kjør en eksakt revisjon

    Registrer Agent, instruksjon, modell, verktøy, Knowledge, profil, cases og repetisjoner for sammenlignbare resultater.

  3. 03
    Gjør feil til regresjoner

    Legg til enhver vesentlig pilot- eller produksjonsfeil og krev pass før neste publisering.

05

Evaluations i Prostir

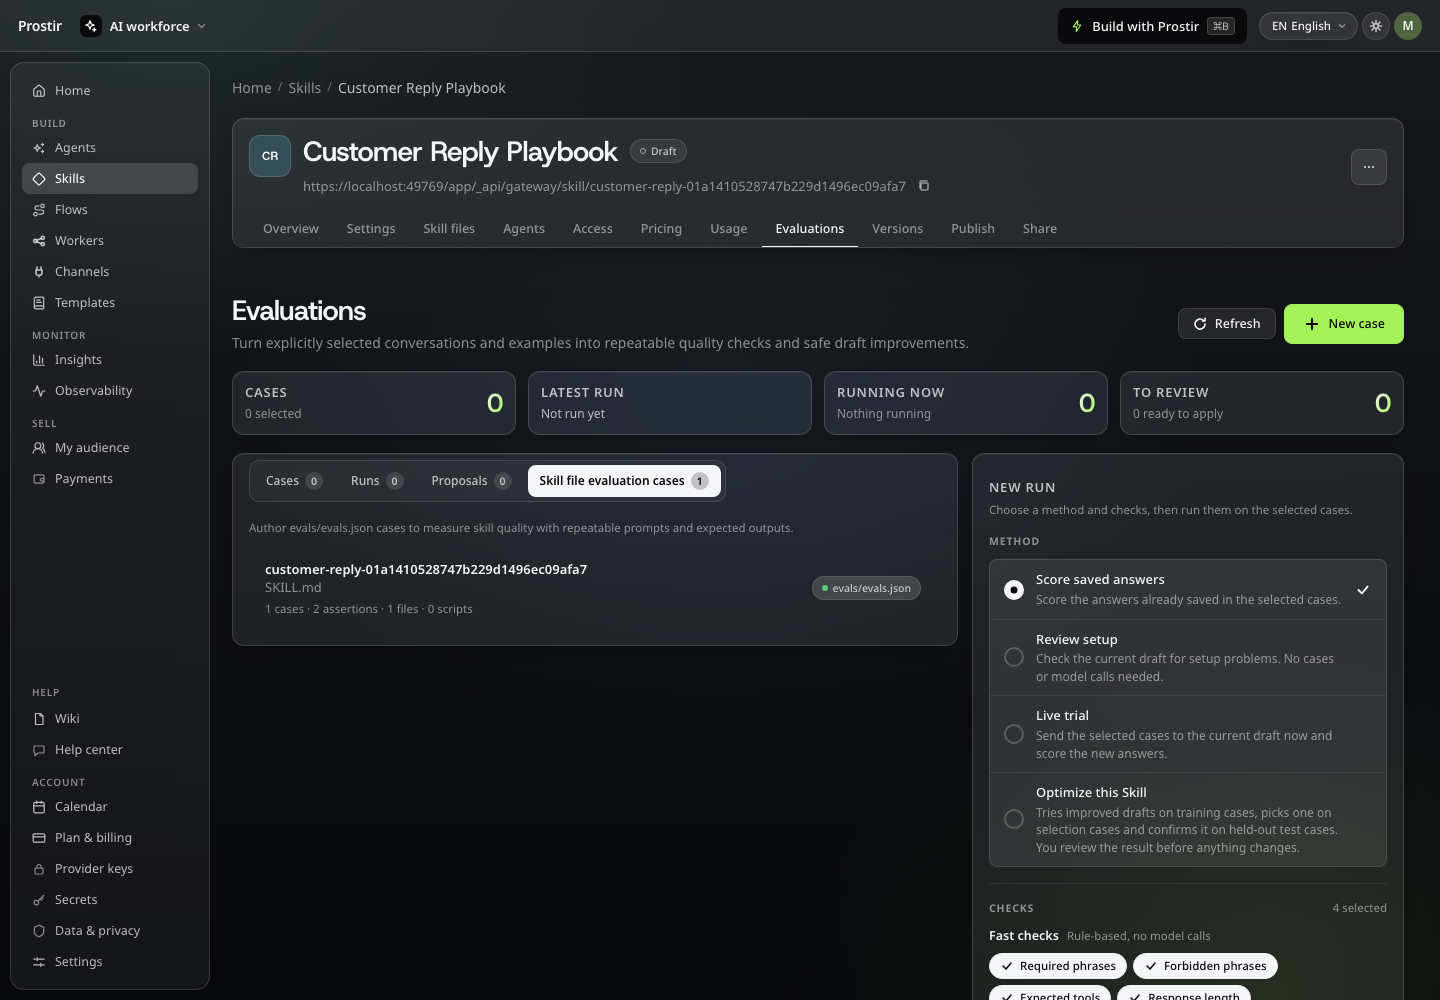
Prostir har én implementert Evaluations-modul delt av Agent, Skill og Company med typede cases, profiler, runs, resultater, feilsignaler og forslag på det eksakte produktet.

Evidens tas inn først etter eksplisitt valg og samtykke. Deterministiske kontroller trenger ingen judge; Microsoft.Extensions.AI.Evaluering krever kredittgodkjenning og positivt budsjett.

En run endrer eller publiserer aldri produktet. Et forslag venter på menneskelig gjennomgang og kan bare endre draftet dersom den eksakte revisjonen fortsatt gjelder.

06

Hva om den svarer feil eller ikke gjør jobben ferdig?

AI kan fortsatt misforstå en forespørsel, bruke mangelfull informasjon eller feile under en handling. Gi Agent gode kilder og tydelige grenser, og test også eksempler med feil. Bruker du Flow, bør du se på kjøringen og det lagrede resultatet. Et selvsikkert svar beviser ikke at jobben er fullført.

Et eksempel med Prostir

Spør Store om et produkt for et bestemt leveringsområde. Kunnskapsgrafen kan koble opplysninger om produkter, levering og returregler. Gjeldende pris, lagerstatus og kjøpsprosessen må fortsatt bekreftes av handelssystemet.

Gå gjennom vurderingseksemplene, og be Builder legge til en sjekkliste for svar som du kan bruke igjen.

Dette bør du sjekke først

Test et produkt som ikke er tilgjengelig, kilder som motsier hverandre og en avbrutt handling. Sjekk det faktiske lagrede resultatet før du regner jobben som ferdig.

Kontroller før andre stoler på den Eksempler og evalueringer.
Eksempler og evalueringer.

Løsninger

Bygg en AI-agent for måten bedriften din jobber på

En agent med tydelig jobb, bedriftens kunnskap og en praktisk vei til brukerne. Test virkelige spørsmål, undersøk kilder og tillatte handlinger, og forbedre i Builder før invitasjoner.

Løsninger

Din neste agent begynner med arbeidet ditt.

Velg ett kundespørsmål eller en rutine, og bygg en agent med din egen kunnskap. Start med en 7-dagers Creator-prøve uten betalingskort.

Bildevisning